Ir para uma seção
01 / OCR
Manter as imagens locais sem exigir outra instalação
- Problema
- As imagens precisavam permanecer no dispositivo, sem exigir outra instalação do advogado.
- Decisão
- Executar OCR no navegador e administrar concorrência, memória e gravação incremental.
- Consequência
- A equipe implementou controles locais e acompanhamento da indexação por página, com novas tentativas.
- Limite
- Salvar resultados não garantia retomar todo o processamento. Desktop continua uma direção a validar.
Onde cada parte do documento é processada
Dispositivo do usuário
As imagens permanecem no dispositivo neste fluxo.
Nuvem
PDF.jsPreparação das páginas
Tesseract.jsReconhecimento no navegador
IndexedDBResultados intermediários
Ler o episódio completo
No fluxo local de PDFs, as imagens das páginas precisavam permanecer na máquina do usuário porque podiam conter material sensível. O texto extraído podia seguir para busca e análise na nuvem. Essa distinção orientava o desenho: processar localmente as imagens não significava manter todo o tratamento do documento fora da nuvem.
A escolha inicial foi executar o OCR no navegador. Nosso usuário era um advogado não técnico; queríamos evitar a instalação e a operação de outro programa para usar um sistema web. Usamos PDF.js para preparar as páginas e Tesseract.js para o reconhecimento do texto.
O custo dessa escolha apareceu na execução. Na nossa experiência, o processamento consumia bastante memória e, em alguns casos, encerrava o navegador. Clientes com máquinas mais fracas tinham ainda mais dificuldade. Evitar a instalação não eliminava a dependência do dispositivo.
A equipe passou a ajustar a concorrência à capacidade da máquina, processar páginas em blocos, liberar recursos de renderização e recriar workers entre blocos. Esses workers executavam no navegador; não eram os workers das filas do backend. Também implementamos a gravação incremental dos resultados em IndexedDB, o armazenamento local do navegador.
Salvar resultados intermediários preservava parte do trabalho, mas não garantia retomada automática de qualquer interrupção. Era preciso considerar também a recuperação do conteúdo original e os caminhos de reprocessamento ainda incompletos.
Depois da extração, havia outra fronteira: indexar o texto. Implementamos acompanhamento por página, novas tentativas após falhas e identificadores estáveis no Elasticsearch. Repetir a indexação da mesma página não deveria criar um segundo documento. Essa proteção se limitava à indexação; não tornava todos os efeitos do pipeline idempotentes. Minha contribuição nessa evolução incluiu o reprocessamento das páginas que falharam.
O navegador resolveu o atrito inicial de instalação, mas manteve restrições de memória e execução que precisávamos administrar. Considero uma versão desktop como direção de evolução para ter mais controle do processamento local. É uma alternativa a validar, inclusive na instalação e manutenção, não uma entrega deste relato.
Documentação pública explica mecanismos; não comprova a implementação ou os resultados do produto.
02 / Relatórios
O custo de obter uma resposta utilizável
- Problema
- JSONs extensos precisavam respeitar o esquema e manter qualidade jurídica.
- Decisão
- Validar e recuperar respostas, considerando o custo de obter um relatório utilizável.
- Consequência
- A recuperação evoluiu de correções e novas validações para o tratamento dos campos problemáticos.
- Limite
- A troca de modelo não eliminou falhas. Não há benchmark reproduzível de custo ou acerto jurídico.
Gerar uma resposta era só parte do trabalho
falha estrutural
estrutura aceita
Qualidade jurídica é uma exigência distinta.
Por que validar campos faz diferença
Este exemplo simplificado ilustra uma falha de tipo em um JSON parseável. Não é o esquema proprietário, uma resposta real do modelo ou evidência de recuperação em produção.
Antes da correção
{
  "event": "Synthetic event A",
  "sourceIds": "document-a"
}
Após corrigir o campo
{
  "event": "Synthetic event A",
  "sourceIds": [
    "document-a"
  ]
}ZodValidação do esquema
GPT-5Geração no fluxo descrito
JSONEstrutura consumida pelo sistema
Ler o episódio completo
Os relatórios jurídicos precisavam seguir um esquema validado com Zod, muitas vezes com JSONs extensos. Havia três exigências diferentes: o JSON precisava ser parseável, os campos precisavam respeitar o esquema e o conteúdo precisava ter qualidade jurídica. Passar na validação estrutural não demonstrava que a análise estava correta.
Avaliávamos modelos considerando essas exigências nas cargas do produto. Quando a estrutura falhava, corrigir ou repetir a geração acrescentava tempo e custo. Por isso, o preço por chamada era insuficiente: o que importava era o custo de chegar a um relatório utilizável, incluindo as tentativas descartadas e as correções.
Nesse processo, passamos do Gemini 2.5 Pro para GPT-5. A troca não eliminou as falhas. Trabalhei na recuperação de respostas inválidas, com sanitização, correção e novos ciclos de validação. A implementação evoluiu depois para corrigir apenas os campos problemáticos, em vez de refazer indiscriminadamente toda a resposta.
Também houve ajustes de compatibilidade entre os esquemas e a API de Structured Outputs. Parte da dificuldade estava na integração, não apenas no modelo. Essas mudanças sustentam o relato de uma escolha acompanhada de trabalho de recuperação; não uma conclusão sobre toda a família Gemini ou uma garantia de acerto jurídico dos modelos adotados.
O trade-off era manter validação e recuperação no sistema, mesmo depois de trocar o modelo. Não temos uma comparação reproduzível que permita quantificar quanto essa escolha reduziu falhas ou custo total. A decisão foi avaliar a resposta que conseguíamos aproveitar, e não somente o preço anunciado por token.
Documentação pública explica mecanismos; não comprova a implementação ou os resultados do produto.
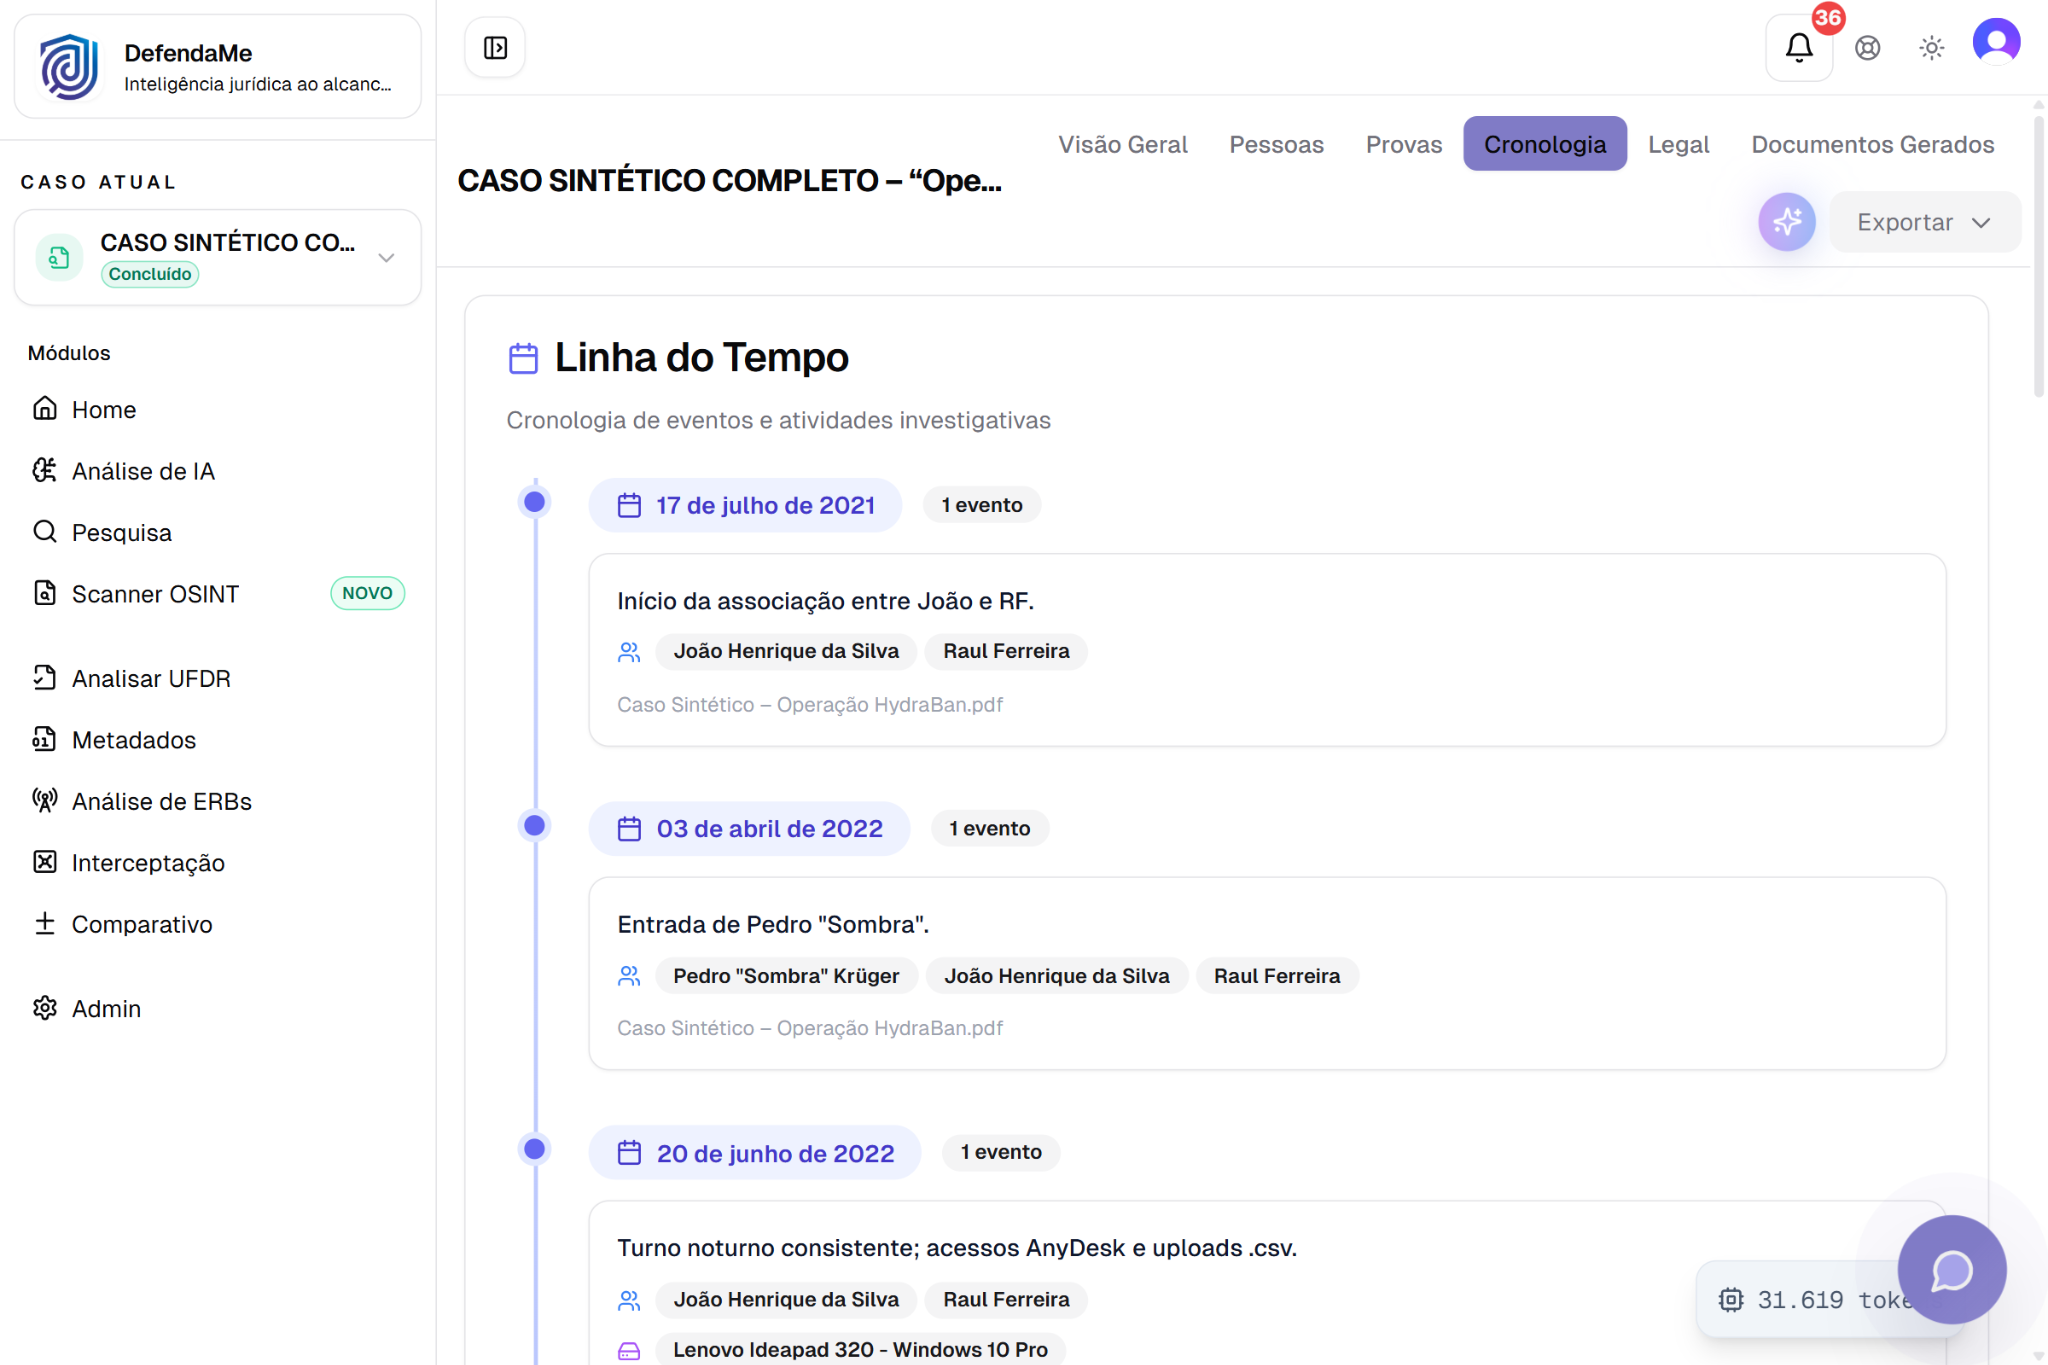
A cronologia apresenta eventos com datas, pessoas e referência ao documento associado. É um exemplo de como informações estruturadas aparecem na interface, com dados sintéticos.
Ver captura completa (abre em nova aba)03 / Observabilidade
Entender o que acontecia na mão dos usuários
- Problema
- Era difícil entender o que acontecia durante o uso do produto.
- Decisão
- Combinar captura de erros e eventos das etapas com logs estruturados e correlação.
- Consequência
- Foram implementados mecanismos para relacionar eventos e investigar execuções nos pontos instrumentados.
- Limite
- A instrumentação não cobria todos os caminhos nem comprova redução no tempo de diagnóstico.
SentryCaptura e contexto de erros
JSONLogs estruturados
CorrelaçãoRelacionar eventos
Ler o episódio completo
Orientei a adoção do Sentry para entendermos melhor as falhas durante o uso do produto, com participação do Ryan na implementação. Combinamos a captura de erros no navegador com eventos de etapas como upload, OCR e análise, nos pontos instrumentados do cliente e do servidor. O contexto incluía a operação em andamento e eventos de início, conclusão ou falha.
Depois, trabalhei na evolução dos logs estruturados em JSON e da correlação entre execuções. Conforme o ponto instrumentado, os registros incluíam execução, serviço, etapa, duração e tentativa. Um identificador de correlação permitia relacionar eventos que, antes, dependeriam da leitura de mensagens isoladas.
Isso acrescentou mecanismos para investigar o processamento, mas não significava rastreamento completo de todos os caminhos nem demonstrava uma redução medida no tempo de diagnóstico. O resultado que posso descrever aqui é a instrumentação implementada e sua evolução.
O contexto útil para investigar também precisava ter limites. Aplicamos mascaramento e filtros para restringir o envio de conteúdo sensível. Mais telemetria exigia mais cuidado com a coleta; esses mecanismos não eram garantia de anonimização integral.
Documentação pública explica mecanismos; não comprova a implementação ou os resultados do produto.
04 / Busca
Transferir a geração dos embeddings
- Problema
- A aplicação executava embeddings e alimentava duas camadas de busca.
- Decisão
- Transferir a geração dos embeddings ao fluxo de ingestão associado ao Elasticsearch.
- Consequência
- A execução do modelo saiu do servidor da aplicação e a busca textual e vetorial foi reunida.
- Limite
- A inferência continuou consumindo recursos e a dependência da infraestrutura de busca aumentou.
A mesma responsabilidade, em outro lugar
Antes
Depois
O destaque acompanha a responsabilidade transferida. O custo computacional da inferência continua existindo.
ElasticsearchBusca textual e vetorial
PostgreSQLDestino vetorial anterior
Ler o episódio completo
Usávamos Elasticsearch para busca textual e PostgreSQL para busca vetorial. A aplicação também executava o modelo de embeddings sobre os textos, dividindo processamento e memória com as funcionalidades do produto.
A aplicação alimentava duas camadas de busca e executava o modelo de embeddings.
Como o Elasticsearch já fazia parte da infraestrutura, transferimos a responsabilidade pela geração dos embeddings para o fluxo de ingestão associado à busca. A aplicação passou a enviar o texto, e reunimos a busca textual e a vetorial no Elasticsearch.
O custo computacional da inferência continuava existindo. A mudança retirava a execução do modelo do servidor da aplicação e concentrava a indexação na infraestrutura de busca. Isso também aumentava nossa dependência dessa infraestrutura.
Os diagramas representam essa transferência de responsabilidade. Não detalham o mecanismo de inferência nem a topologia interna.
Documentação pública explica mecanismos; não comprova a implementação ou os resultados do produto.
05 / Operação
Mais controle também significava mais responsabilidade
- Problema
- Cargas longas, custos de plataforma e divergências de configuração criavam atritos.
- Decisão
- A equipe migrou para uma Droplet e adotou o Doppler para centralizar a configuração.
- Consequência
- Ganhamos controle e assumimos diretamente deploy, proxy, containers e recuperação de processos.
- Limite
- Eu defendia permanecer na Vercel. Hoje preferiria separar a camada web dos serviços persistentes; essa alternativa não foi medida.
VercelOperação gerenciada anterior
DigitalOceanInfraestrutura sob operação da equipe
DopplerConfiguração no deploy
| Alternativa | O que oferece | Responsabilidade e limite |
|---|---|---|
| Manter tudo na Vercel · posição defendida à época | Preservar a operação gerenciada da plataforma. | As cargas longas e o custo por assento continuavam sendo os atritos relatados. |
| Migrar tudo para a Droplet · decisão da equipe | Controle sobre processos e dependências. | A equipe passou a operar deploy, proxy, containers, memória e recuperação. |
| Web na Vercel e serviços fora · avaliação retrospectiva | Preservar a camada web gerenciada e mover as cargas que precisavam de outro modelo. | É a alternativa que eu preferiria hoje; custo e disponibilidade não foram comparados em condições equivalentes. |
Ler o episódio completo
Executar embeddings, indexação e análises podia levar muitos minutos. Acomodar essas cargas no modelo de execução da Vercel estava ficando inconveniente. A equipe decidiu migrar para uma Droplet na DigitalOcean; a camada web foi junto porque, na nossa avaliação, o custo fixo da máquina era mais conveniente que o custo por assento da plataforma.
Eu estava entre os que mais defendiam permanecer na Vercel, pelo trabalho de operação gerenciada que ela assumia. Chegamos a um acordo pela migração, ainda com minhas ressalvas. A decisão e o trabalho de lidar com as consequências foram coletivos.
Ganhamos controle sobre processos e dependências, mas passamos a cuidar diretamente de deploy, proxy, comunicação entre containers, memória e recuperação de processos. Tivemos problemas nessas camadas e precisamos dedicar tempo a investigá-los. Para uma equipe pequena, esse trabalho disputava atenção com as funcionalidades do produto.
Retrospectivamente, considero que mover a aplicação inteira foi um erro. Eu teria preferido manter a camada web na Vercel e mover apenas os serviços que precisavam de outro modelo de execução. É uma avaliação minha hoje, não uma alternativa cujo custo ou disponibilidade tenhamos medido em condições equivalentes.
A configuração trouxe outro problema concreto. A aplicação acumulou centenas de variáveis de ambiente, entre configurações e segredos, e divergências entre ambientes estavam entre os bugs que encontrávamos com frequência. Avaliamos alternativas, especialmente o HashiCorp Vault, e escolhemos o Doppler pela simplicidade relativa para o nosso contexto. Participei diretamente da integração ao deploy, usando a CLI para fornecer as variáveis ao processo.
Centralizar a configuração não garantia que ela chegasse a cada serviço. Uma correção posterior tratou justamente de uma variável disponível no Doppler que não era repassada ao container pelo Compose. A integração mudou a gestão da configuração; continuávamos responsáveis por conferir sua propagação.
Documentação pública explica mecanismos; não comprova a implementação ou os resultados do produto.
06 / Resultado
O que esse recorte permite afirmar
Implementamos controles para o OCR local, acompanhamento e retentativas na indexação por página, recuperação de respostas estruturadas e instrumentação para investigar falhas. Essas entregas tinham limites diferentes: salvar uma página não assegurava retomar todo o processamento; validar um JSON não assegurava qualidade jurídica; capturar eventos não assegurava cobertura de todas as falhas.
A parte mais importante dessas decisões foi delimitar a responsabilidade de cada etapa. O navegador evitava outra instalação, mas dependia da máquina do advogado. O modelo precisava produzir uma estrutura utilizável, e a aplicação ainda precisava validá-la. A infraestrutura mais aberta nos dava controle, mas também exigia operação. Foi nessas fronteiras que boa parte do trabalho de engenharia aconteceu.
07 / Autoria
Autoria, evidência e limites
O DefendaMe é construído por uma equipe. Uso “nós” para as decisões e implementações coletivas e delimito minha contribuição nos episódios. Ryan participou da implementação do Sentry; as otimizações de OCR e as mudanças de infraestrutura também tiveram trabalho de outras pessoas.
Este texto reúne meu relato e descrições de código, documentos e histórico examinados durante a coleta editorial. As referências públicas abaixo explicam mecanismos; não comprovam os resultados do DefendaMe. Não publico código proprietário, dados de clientes ou métricas sem medição rastreável.
Referências técnicas
Documentação pública explica mecanismos; não comprova a implementação ou os resultados do produto.
- Tesseract.js — desempenho e limites de memória por worker ↗
- OpenAI — JSON válido, aderência ao esquema e limites de Structured Outputs ↗
- Doppler — injeção de configuração pela CLI ↗
- Docker Compose — fornecimento de variáveis ao container ↗
- Sentry — configuração e captura de erros no Next.js ↗
- Elasticsearch — inferência em pipelines de ingestão ↗