Aller à une section
01 / OCR
Conserver les images en local sans imposer une autre installation
- Problème
- Les images des pages devaient rester sur l’appareil, sans imposer une autre installation.
- Décision
- Exécuter l’OCR dans le navigateur et gérer la concurrence, la mémoire et l’enregistrement progressif.
- Conséquence
- L’équipe a mis en place des contrôles locaux et un suivi de l’indexation par page avec de nouvelles tentatives.
- Limite
- Enregistrer les résultats ne garantissait pas la reprise de tout le traitement. Une application de bureau reste une alternative à valider.
Où chaque partie du document est traitée
Appareil de l’utilisateur
Les images restent sur l’appareil dans ce parcours.
Cloud
PDF.jsPréparation des pages
Tesseract.jsReconnaissance dans le navigateur
IndexedDBRésultats intermédiaires
Lire l’épisode complet
Dans le traitement local des PDF, les images des pages devaient rester sur l’appareil de l’utilisateur, car elles pouvaient contenir des éléments sensibles. Le texte extrait pouvait être envoyé dans le cloud pour la recherche et l’analyse. Cette distinction a guidé la conception : traiter les images en local ne signifiait pas garder tout le traitement documentaire hors du cloud.
Nous avons d’abord choisi d’exécuter l’OCR dans le navigateur. Notre utilisateur était un avocat non technicien ; nous voulions éviter de lui imposer une autre application pour utiliser un système web. Nous utilisions PDF.js pour préparer les pages et Tesseract.js pour reconnaître le texte.
Le coût de ce choix est apparu à l’exécution. Dans notre expérience, le traitement consommait beaucoup de mémoire et provoquait parfois la fermeture du navigateur. Les clients équipés de machines moins puissantes rencontraient davantage de difficultés. Éviter une installation ne supprimait pas la dépendance à l’appareil.
L’équipe a adapté la concurrence à la capacité de la machine, traité les pages par lots, libéré les ressources de rendu et recréé les workers entre les lots. Ces workers s’exécutaient dans le navigateur ; ils étaient distincts des workers de file d’attente du backend. Nous avons aussi mis en place l’enregistrement progressif des résultats dans IndexedDB, la base de données locale du navigateur.
L’enregistrement de résultats intermédiaires préservait une partie du travail, sans garantir une reprise automatique après toute interruption. La reprise dépendait aussi de l’accès au contenu d’origine et de chemins de retraitement encore incomplets.
Après l’extraction venait une autre frontière : l’indexation du texte. Nous avons mis en place un suivi par page, de nouvelles tentatives après échec et des identifiants stables dans Elasticsearch. Réindexer la même page ne devait pas créer un second document. Cette protection concernait l’indexation ; elle ne rendait pas tous les effets du pipeline idempotents. Ma contribution comprenait le retraitement des pages en échec.
Le navigateur supprimait l’étape d’installation initiale, mais conservait des contraintes de mémoire et d’exécution à gérer. Je considère une application de bureau comme une piste possible pour mieux maîtriser le traitement local. Cela reste une alternative à valider, y compris pour l’installation et la maintenance, et non une réalisation décrite ici.
La documentation publique explique les mécanismes ; elle n’établit pas l’implémentation ni les résultats du produit.
02 / Rapports
Le coût d’une réponse exploitable
- Problème
- Les JSON volumineux devaient respecter un schéma et conserver une qualité juridique.
- Décision
- Valider et récupérer les réponses en tenant compte du coût d’un rapport exploitable.
- Conséquence
- La récupération a évolué des corrections et nouvelles validations vers la réparation des champs problématiques.
- Limite
- Changer de modèle n’a pas éliminé les échecs. Il n’existe pas de benchmark reproductible du coût ou de la qualité juridique.
Générer une réponse n’était qu’une partie du travail
échec structurel
structure acceptée
La qualité juridique est une exigence distincte.
Pourquoi valider les champs
Cet exemple simplifié illustre une erreur de type dans un JSON interprétable. Il ne s’agit ni du schéma propriétaire, ni d’une réponse réelle du modèle, ni d’une preuve de récupération en production.
Avant correction
{
  "event": "Synthetic event A",
  "sourceIds": "document-a"
}
Après correction du champ
{
  "event": "Synthetic event A",
  "sourceIds": [
    "document-a"
  ]
}ZodValidation du schéma
GPT-5Génération dans le parcours décrit
JSONStructure exploitée par le système
Lire l’épisode complet
Les rapports juridiques devaient respecter un schéma validé avec Zod, souvent avec des réponses JSON volumineuses. Trois exigences étaient distinctes : le JSON devait être interprétable, ses champs devaient respecter le schéma et le contenu devait avoir une qualité juridique. Réussir la validation structurelle ne démontrait pas que l’analyse était correcte.
Nous avons évalué les modèles selon ces exigences avec les charges de travail du produit. Quand la structure échouait, réparer ou relancer la génération ajoutait du temps et du coût. Le prix par appel ne suffisait donc pas : ce qui comptait était le coût d’un rapport exploitable, tentatives écartées et corrections comprises.
Au cours de ce travail, nous sommes passés de Gemini 2.5 Pro à GPT-5. Le changement n’a pas éliminé les échecs. J’ai travaillé sur la récupération des réponses invalides par nettoyage, correction et nouvelle validation. L’implémentation a ensuite évolué pour ne réparer que les champs problématiques, plutôt que régénérer indistinctement toute la réponse.
Il a aussi fallu adapter la compatibilité entre les schémas et l’API Structured Outputs. Une partie de la difficulté relevait de l’intégration, pas uniquement du modèle. Ces changements étayent le récit d’un choix de modèle accompagné d’un travail de récupération, sans permettre de conclure sur toute la famille Gemini ni de garantir des réponses juridiquement correctes avec les modèles retenus.
Le compromis consistait à conserver la validation et la récupération dans le système, même après le changement de modèle. Nous ne disposons pas d’une comparaison reproductible quantifiant la réduction des échecs ou du coût total. La décision était d’évaluer les réponses réellement exploitables, plutôt que le seul prix affiché par token.
La documentation publique explique les mécanismes ; elle n’établit pas l’implémentation ni les résultats du produit.
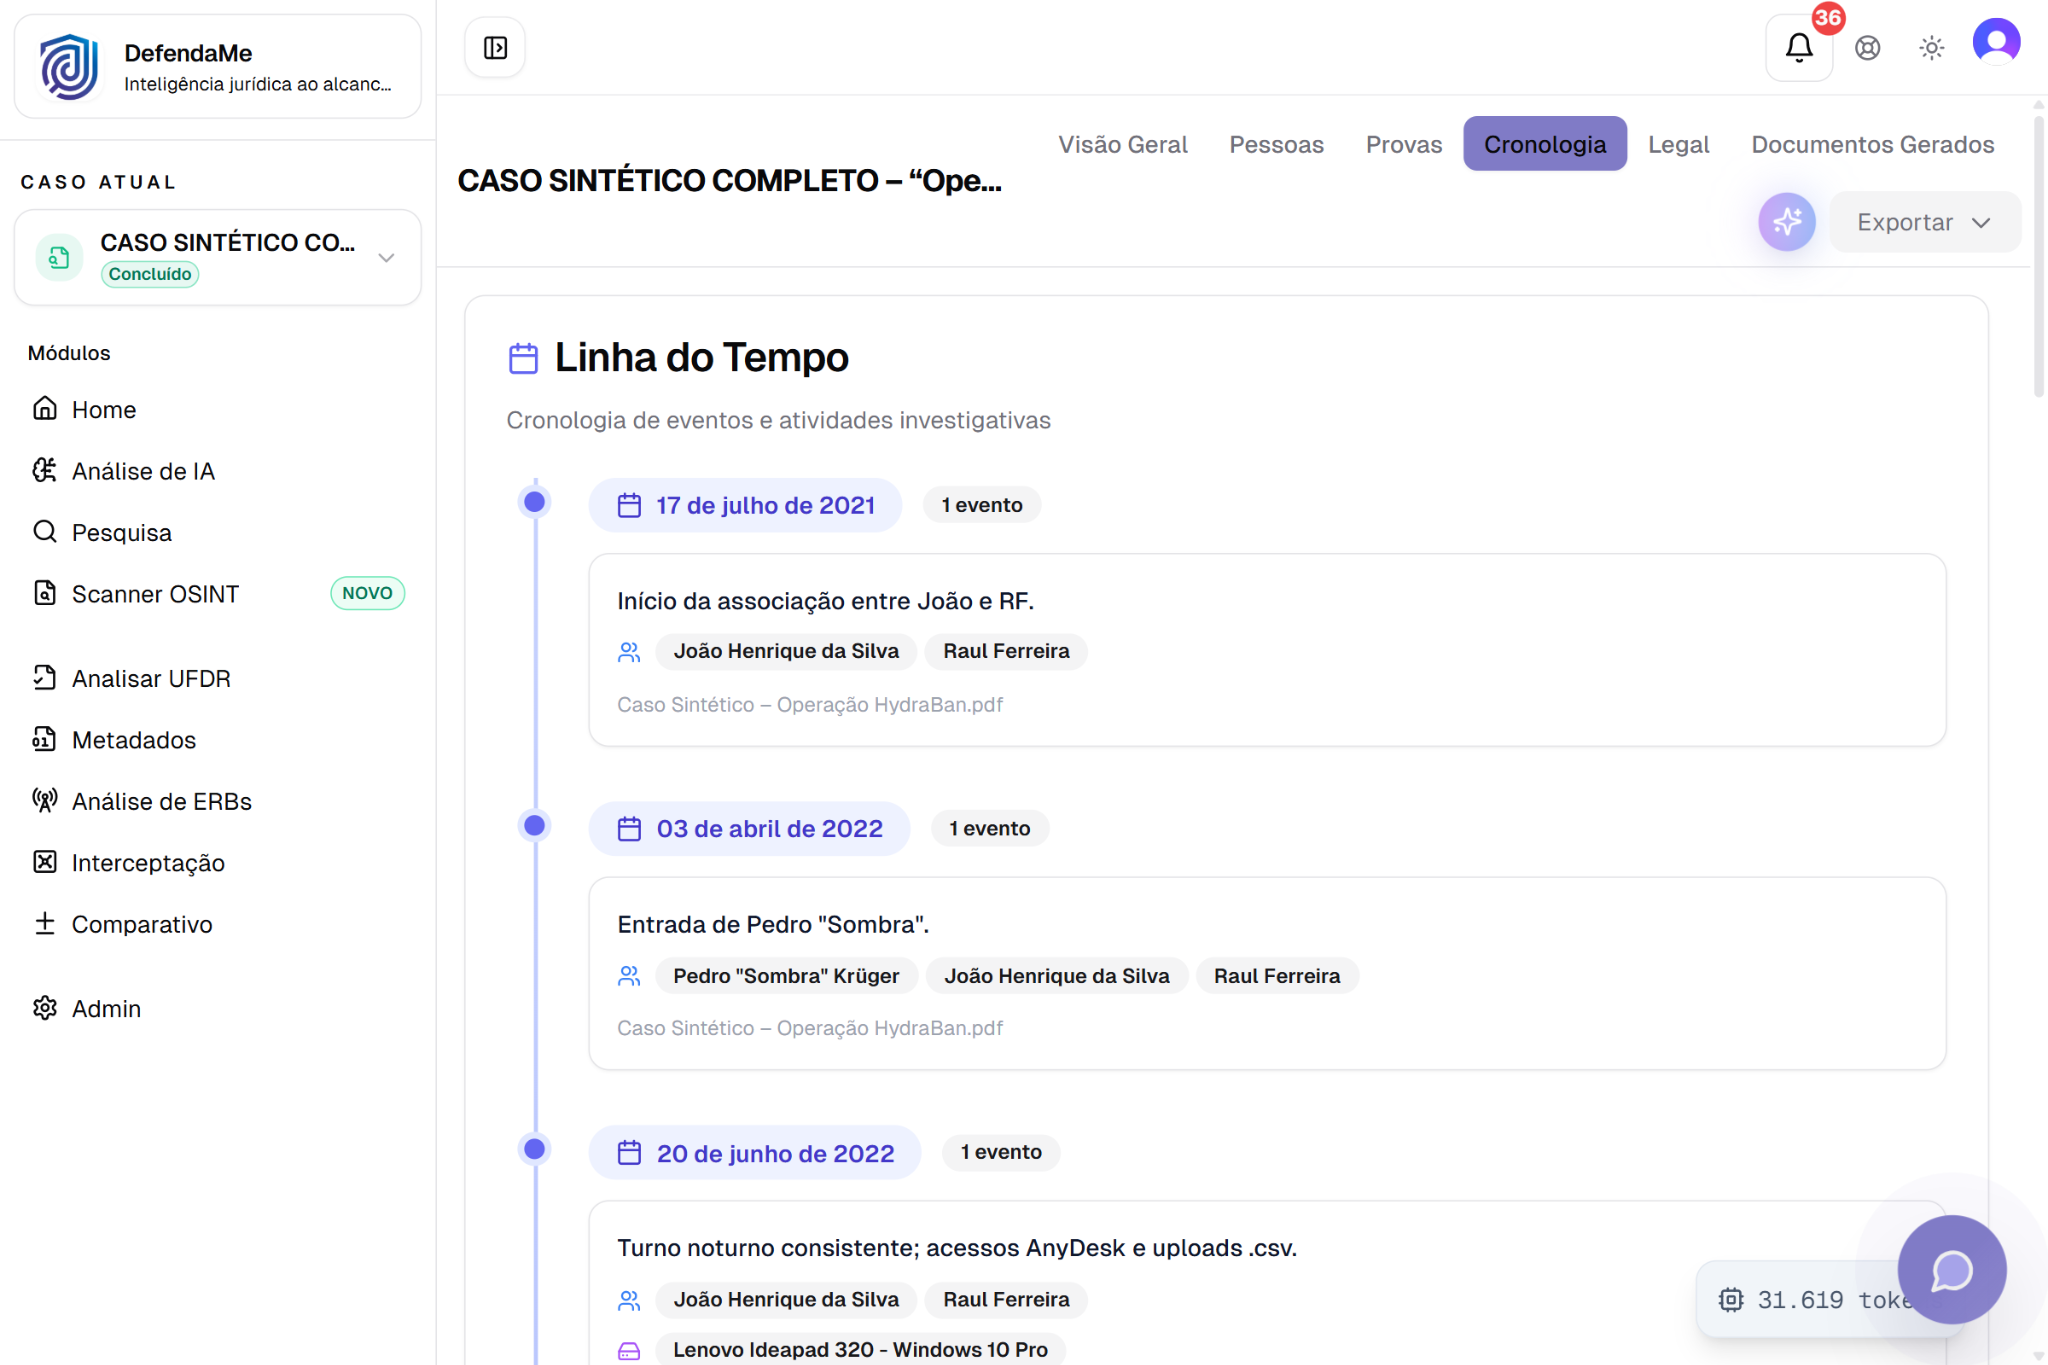
La chronologie présente les événements avec leurs dates, les personnes concernées et une référence au document associé. Elle montre comment les informations structurées apparaissent dans l’interface, à partir de données synthétiques. Interface en portugais ; dossier synthétique.
Voir la capture complète (s’ouvre dans un nouvel onglet)03 / Observabilité
Comprendre ce qui se passait en usage réel
- Problème
- Il était difficile de comprendre ce qui se passait lors de l’utilisation du produit.
- Décision
- Combiner capture des erreurs et événements des étapes avec des logs structurés et de la corrélation.
- Conséquence
- Des mécanismes ont été mis en place pour relier les événements et examiner les exécutions aux points instrumentés.
- Limite
- L’instrumentation ne couvrait pas tous les chemins et ne démontrait pas un diagnostic plus rapide.
SentryCapture et contexte des erreurs
JSONLogs structurés
CorrélationRelier les événements
Lire l’épisode complet
J’ai orienté l’adoption de Sentry pour mieux comprendre les défaillances lors de l’utilisation du produit, avec la participation de Ryan à la mise en place. Nous avons combiné la capture des erreurs du navigateur avec des événements d’étapes comme le téléversement, l’OCR et l’analyse, aux points instrumentés du client et du serveur. Le contexte incluait l’opération en cours et les événements de début, de fin ou d’échec.
J’ai ensuite contribué à l’évolution des logs JSON structurés et à la corrélation entre exécutions. Selon le point instrumenté, les enregistrements incluaient l’exécution, le service, l’étape, la durée et la tentative. Un identifiant de corrélation reliait des événements qui auraient autrement exigé la lecture de messages isolés.
Cela ajoutait des moyens d’investigation du traitement, sans fournir un traçage complet de tous les chemins ni démontrer une réduction mesurée du temps de diagnostic. Le résultat que je peux décrire ici est l’instrumentation mise en place et son évolution.
Le contexte utile à l’investigation devait aussi être limité. Nous avons appliqué du masquage et des filtres pour restreindre la transmission de contenus sensibles. Davantage de télémétrie exigeait davantage de soin dans la collecte ; ces mécanismes ne garantissaient pas une anonymisation complète.
La documentation publique explique les mécanismes ; elle n’établit pas l’implémentation ni les résultats du produit.
04 / Recherche
Déplacer la responsabilité de génération des embeddings
- Problème
- L’application exécutait les embeddings et alimentait deux couches de recherche.
- Décision
- Transférer la génération des embeddings au flux d’ingestion associé à Elasticsearch.
- Conséquence
- L’exécution du modèle a quitté le serveur applicatif et les recherches textuelle et vectorielle ont été réunies.
- Limite
- L’inférence consommait toujours des ressources, et la dépendance à l’infrastructure de recherche augmentait.
La même responsabilité, ailleurs
Avant
Après
La mise en évidence suit la responsabilité déplacée. Le coût de calcul de l’inférence existe toujours.
ElasticsearchRecherche textuelle et vectorielle
PostgreSQLAncienne destination vectorielle
Lire l’épisode complet
Nous utilisions Elasticsearch pour la recherche textuelle et PostgreSQL pour la recherche vectorielle. L’application exécutait aussi le modèle d’embeddings sur les textes, partageant calcul et mémoire avec les fonctionnalités du produit.
L’application alimentait deux couches de recherche et exécutait le modèle d’embeddings.
Elasticsearch faisant déjà partie de l’infrastructure, nous avons transféré la génération des embeddings au flux d’ingestion associé à la recherche. L’application s’est mise à envoyer le texte, et nous avons réuni recherche textuelle et vectorielle dans Elasticsearch.
Le coût de calcul de l’inférence existait toujours. Le changement retirait l’exécution du modèle du serveur applicatif et concentrait l’indexation dans l’infrastructure de recherche. Il renforçait aussi notre dépendance à cette infrastructure.
Les schémas représentent ce transfert de responsabilité. Ils ne détaillent ni le mécanisme d’inférence ni la topologie interne.
La documentation publique explique les mécanismes ; elle n’établit pas l’implémentation ni les résultats du produit.
05 / Exploitation
Plus de contrôle signifiait aussi plus de responsabilités
- Problème
- Les traitements longs, les coûts de plateforme et les divergences de configuration créaient des difficultés.
- Décision
- L’équipe a migré vers une Droplet et adopté Doppler pour centraliser la configuration.
- Conséquence
- Nous avons gagné du contrôle et pris directement en charge le déploiement, les proxys, les conteneurs et la reprise des processus.
- Limite
- Je défendais le maintien sur Vercel. Aujourd’hui, je séparerais la couche web des services persistants ; cette alternative n’a pas été mesurée.
VercelAncienne exploitation gérée
DigitalOceanInfrastructure exploitée par l’équipe
DopplerConfiguration au déploiement
| Alternative | Ce qu’elle offre | Responsabilité et limites |
|---|---|---|
| Tout garder sur Vercel · position défendue à l’époque | Conserver l’exploitation gérée par la plateforme. | Les traitements longs et le coût par siège restaient les difficultés rapportées. |
| Tout migrer vers une Droplet · décision de l’équipe | Contrôler les processus et les dépendances. | L’équipe a pris en charge déploiement, proxys, conteneurs, mémoire et reprise. |
| Web sur Vercel, services ailleurs · regard rétrospectif | Conserver une couche web gérée et déplacer les charges nécessitant un autre modèle. | L’alternative que je préférerais aujourd’hui ; coût et disponibilité n’ont pas été comparés dans des conditions équivalentes. |
Lire l’épisode complet
L’exécution des embeddings, de l’indexation et des analyses pouvait prendre de nombreuses minutes. Adapter ces charges au modèle d’exécution de Vercel devenait contraignant. L’équipe a décidé de migrer vers une Droplet DigitalOcean ; la couche web a suivi, car nous estimions le coût fixe de la machine plus avantageux que le coût par siège de la plateforme.
Je faisais partie des personnes qui défendaient le plus le maintien sur Vercel, pour le travail d’exploitation géré par la plateforme. Nous sommes parvenus à un accord pour migrer, sans lever mes réserves. La décision et le travail nécessaire pour en gérer les conséquences étaient collectifs.
Nous avons gagné le contrôle des processus et des dépendances, mais sommes devenus directement responsables du déploiement, du proxy, de la communication entre conteneurs, de la mémoire et de la reprise des processus. Nous avons rencontré des problèmes dans ces couches et consacré du temps à les examiner. Pour une petite équipe, ce travail entrait en concurrence avec les fonctionnalités du produit.
Avec le recul, je considère que déplacer toute l’application était une erreur. J’aurais préféré conserver la couche web sur Vercel et ne déplacer que les services nécessitant un autre modèle d’exécution. C’est mon appréciation actuelle, pas une alternative dont nous aurions mesuré le coût ou la disponibilité dans des conditions équivalentes.
La configuration posait un autre problème concret. L’application avait accumulé des centaines de variables d’environnement, paramètres et secrets compris, et les divergences entre environnements figuraient parmi les bugs fréquents. Nous avons évalué les alternatives, notamment HashiCorp Vault, et choisi Doppler pour sa simplicité relative dans notre contexte. J’ai contribué directement à son intégration au déploiement, avec la CLI pour fournir les variables au processus.
Centraliser la configuration ne garantissait pas sa transmission à chaque service. Une correction ultérieure a traité le cas d’une variable disponible dans Doppler que Compose ne transmettait pas à un conteneur. L’intégration changeait la gestion de la configuration ; nous restions responsables de vérifier sa propagation.
La documentation publique explique les mécanismes ; elle n’établit pas l’implémentation ni les résultats du produit.
06 / Réalisations
Ce que ce récit permet d’affirmer
Nous avons mis en place des contrôles d’OCR local, le suivi et les nouvelles tentatives d’indexation par page, la récupération de réponses structurées et l’instrumentation d’investigation des défaillances. Ces réalisations avaient des limites distinctes : enregistrer une page ne garantissait pas la reprise de tout le traitement ; valider du JSON ne garantissait pas la qualité juridique ; capturer des événements ne garantissait pas de couvrir tous les échecs.
Le plus important dans ces décisions était de définir la responsabilité de chaque étape. Le navigateur évitait une autre installation, mais dépendait de la machine de l’avocat. Le modèle devait produire une structure exploitable, et l’application devait encore la valider. Une infrastructure plus ouverte nous donnait du contrôle, mais exigeait aussi du travail d’exploitation. Une grande partie de l’ingénierie se jouait à ces frontières.
07 / Contributions
Contributions, preuves et limites
DefendaMe est construit par une équipe. J’utilise « nous » pour les décisions et réalisations collectives et précise ma contribution à chaque épisode. Ryan a participé à la mise en place de Sentry ; les optimisations de l’OCR et les changements d’infrastructure ont aussi impliqué le travail d’autres personnes.
Ce texte réunit mon récit et des descriptions de code, de documents et d’historique examinés lors de la recherche éditoriale. Les références publiques ci-dessous expliquent les mécanismes ; elles n’établissent pas les résultats de DefendaMe. Je ne publie ni code propriétaire, ni données client, ni métriques sans mesure traçable.
Références techniques
La documentation publique explique les mécanismes ; elle n’établit pas l’implémentation ni les résultats du produit.
- Tesseract.js — performances et contraintes de mémoire des workers ↗
- OpenAI — JSON valide, respect du schéma et limites de Structured Outputs ↗
- Doppler — injection de configuration par la CLI ↗
- Docker Compose — transmission de variables aux conteneurs ↗
- Sentry — configuration de Next.js et capture des erreurs ↗
- Elasticsearch — inférence dans les pipelines d’ingestion ↗